01
课件不是一段纯文本
- 问题
- PPTX 的文字可能藏在组合元素和表格中,直接按文件顺序读取会破坏页面语义。
- 动作
- 递归提取文本框、组合元素和表格,再按纵向坐标还原页面阅读顺序;PDF 按页提取并分块。
- 价值
- 后续检索和讲解保留“第几页、哪一章”的上下文,而不是把整份课件搅成一段文本。
01 · 公司实习 · 负责全栈与 AI 技术实现
让 AI 参与学习前、中、后全过程,并保留知识与调用证据。
面向高校与职教课堂,解析 PPTX/PDF 建立课程知识库,以向量检索与知识图谱关系查询支撑逐页讲解、流式问答、受约束出题和学情反馈,并记录大模型调用全链路。
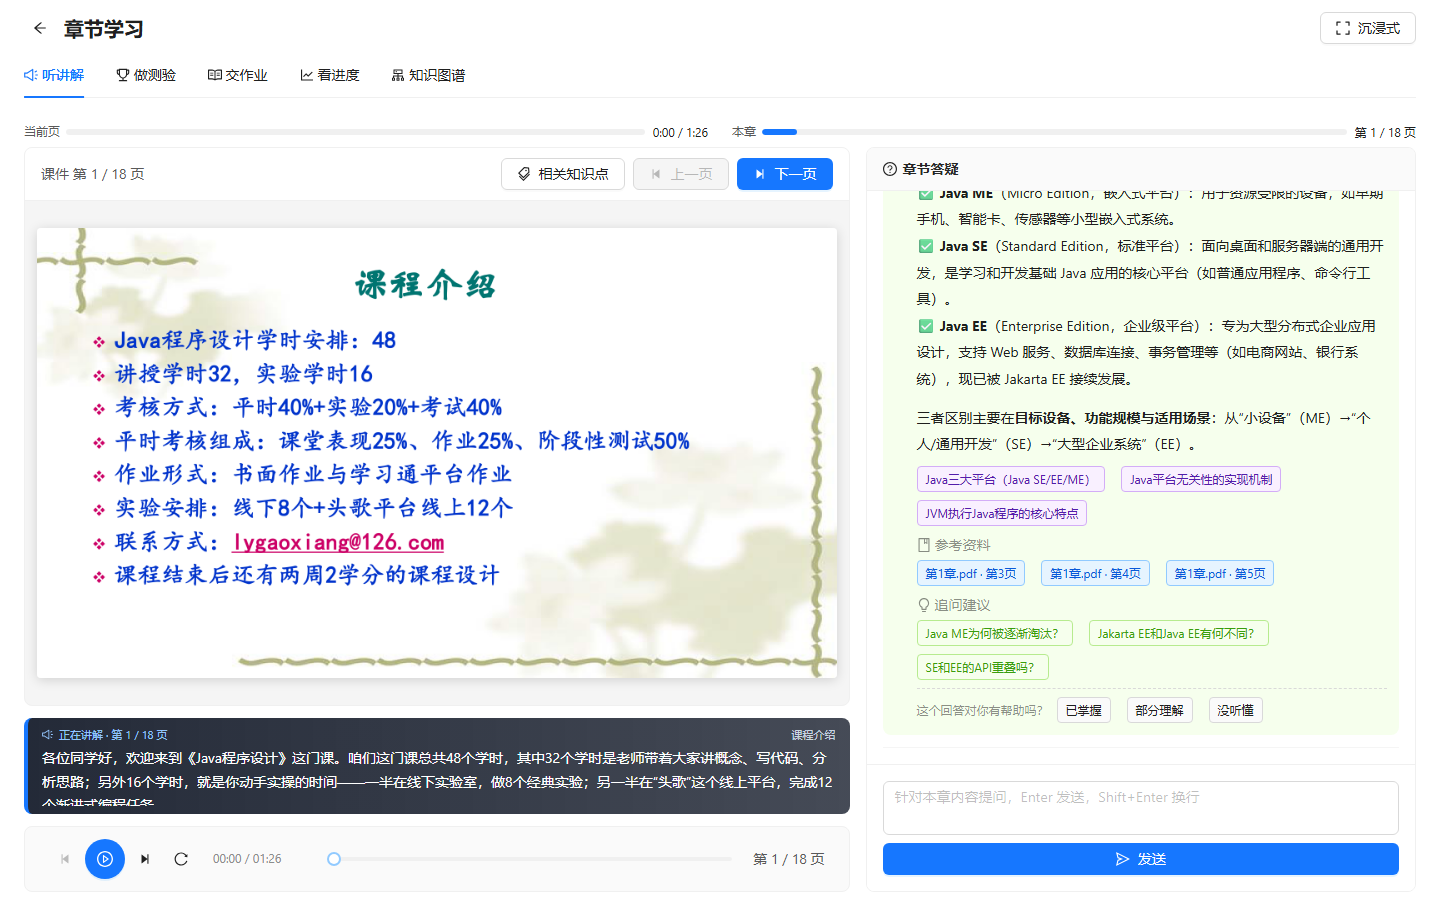
在团队中负责技术实现,覆盖前后端、AI 链路、数据库、测试与部署。
贯通课前备课、课中讲解问答与课后测评分析,并以知识图谱串联知识点关系。
按课程和章节隔离向量检索,结合图谱关系查询;记录模型、Token、耗时与业务上下文。
核心使用流程
教师上传 PPTX 或 PDF,系统保留页面边界并进入解析流程。
提取页面文本、表格与组合元素,按课程和章节建立向量知识库,并抽取六类知识点关系。
生成逐页讲解,以向量内容与图谱关系的组合查询支撑流式问答和来源定位。
按知识点约束生成测验,汇总掌握度与学习报告;调用记录为成本和异常分析提供依据。
关键实现
界面证据
我的职责
在团队中负责后端、前端、AI 链路、数据库、接口联调、测试、部署和后续维护。
亲自完成课件解析、课程知识库、知识图谱、组合查询、流式问答、受约束出题、学情链路和 AI 调用统计。
系统已经部署并在实际场景使用,项目重点是课件处理、课程问答和教学反馈链路。
实现取舍
课程材料与章节课件按 metadata 过滤,避免不同课程内容串用。
模型抽取的关系只允许引用已有知识点,经过类型白名单、节点白名单和去自环校验后入库。
向量入库、逐页脚本和报告生成分别降级,不让 AI 弱依赖阻断确定性业务。
课堂问答使用 POST + fetch reader 解析 SSE,适配携带问题正文的流式请求。
Evidence-based Q&A
直接追问职责、取舍、失败处理和能力边界。回答只使用已确认可公开的项目证据,并提供对应页面来源。
继续了解